robots.txt Dosyası Nasıl Yapılandırılır?
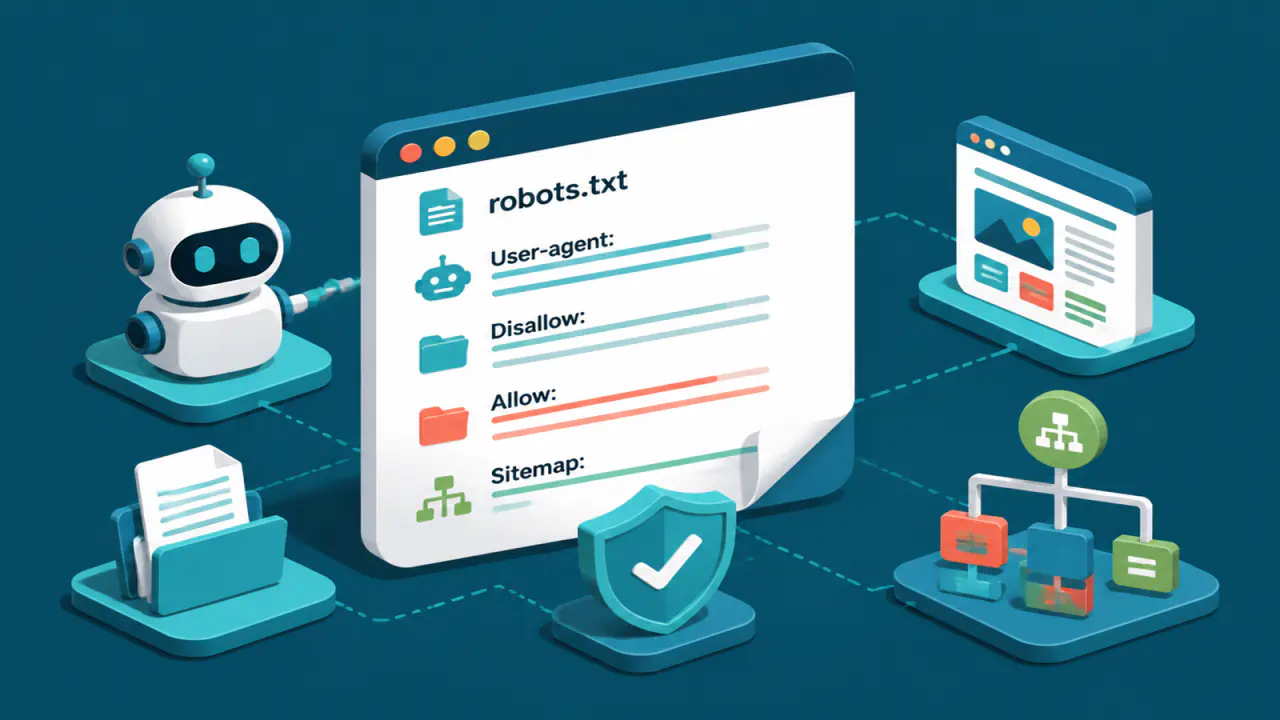
robots.txt, arama motoru botlarına bir web sitesindeki hangi yolları taramalarının istendiğini bildiren, herkese açık düz metin dosyasıdır. Bu yöntem REP (Robots Exclusion Protocol) adıyla RFC 9309'da standartlaştırılmıştır. Dosya, uyumlu arama motoru botlarının tarama davranışını yönlendirir; sunucudaki içeriği silmez veya erişim yetkisi uygulamaz.
Tarama, arama motoru botunun bir URL’yi isteyip içeriğini okumasıdır. İndeksleme ise içeriğin arama dizinine eklenmesidir. Bir URL için Disallow kuralı yazılması, o URL'nin gizli kalacağını veya arama sonuçlarından kesin olarak çıkarılacağını göstermez; başka sayfalardan bağlantı alan engelli URL içerik okunmadan sonuçlarda görünebilir.
Doğru yapılandırma için önce hangi yolların taranmaması gerektiğini, sayfanın oluşturulması için hangi kaynakların gerekli olduğunu ve site haritasının gerçek adresini belirleyin. Ardından kuralları en küçük gerekli kapsamla yazın, canlı dosyanın yanıtını ve gerçek URL örneklerini denetleyin.
robots.txt Dosyası Neyi Kontrol Eder, Neyi Etmez?
- Uyumlu arama motoru botlarının belirli URL yollarını taramasına izin verir veya taramamasını ister.
- Tarama trafiğini yönetebilir; ancak kötü niyetli ya da REP kurallarına uymayan istemcileri durdurmaz.
- Dosyada listelenen yolları gizlemez; robots.txt herkes tarafından açılabilir.
- Bir sayfanın indekslenmesini tek başına kesin olarak engellemez.
- Parola, oturum denetimi, sunucu tarafı yetki veya ağ kısıtlamasının yerine geçmez.
Hassas içerik için gerçek erişim denetimi kullanın. Arama sonuçlarında görünmesini istemediğiniz herkese açık içerikte ise taramaya izin verip uygun noindex yönergesini kullanın; arama motoru botu sayfaya ulaşamazsa noindex bilgisini okuyamaz.
Dosyayı Doğru Konum, Kapsam ve Biçimde Sunma
Dosyanın adı tam olarak küçük harfli robots.txt olmalı ve sitenin kökünde /robots.txt yolundan sunulmalıdır. Alt klasöre konan /klasor/robots.txt üst düzey siteyi yönetmez. HTTP ile sunulan dosya yalnız HTTP kapsamına; HTTP'nin TLS ile korunan HTTPS biçimindeki dosya yalnız HTTPS kapsamına uygulanır.
Kapsam; protokol, ana makine adı ve ağ portuyla belirlenir. example.com, www.example.com ve shop.example.com ayrı ana makinelerdir. Standart HTTPS portu 443 açıkça yazılsa da aynı varsayılan kapsamdır; standart dışı bir port kendi robots.txt dosyasını gerektirir. Doğrudan IP adresiyle sunulan dosya da otomatik olarak aynı sunucudaki alan adlarına uygulanmaz.
RFC 9309, dosyanın Unicode metin kodlaması olan UTF-8 ile ve text/plain içerik türünde sunulmasını ister. Kelime işlemci biçimi, HTML sayfası veya geçersiz karakterler bazı satırların yok sayılmasına yol açabilir. RFC uyumlu ayrıştırıcı en az 500 kibibayt (KiB) işleyebilmelidir; Google, 500 KiB sonrasındaki içeriği yok sayar.
User-agent Gruplarını ve Temel Yönergeleri Kurma
Her kural grubu, hedef arama motoru botunu belirten User-agent satırıyla başlar. User-agent: * genel gruptur. Google'ın çeşitli AdsBot ürünleri yıldız grubuyla eşleşmediği için bunlar gerektiğinde resmi ürün belirteçleriyle ayrıca hedeflenmelidir. Disallow taranmaması istenen yolu, Allow daha geniş bir engelin içindeki izinli istisnayı tanımlar. Sitemap ise site haritasının tam adresini bildirir.
User-agent: *
Disallow: /arama-sonuclari/
Allow: /arama-sonuclari/ornek.html

Sitemap: https://example.com/sitemap.xml
Bir grupta art arda birden fazla User-agent satırı bulunabilir. Kurallar başladıktan sonra gelen yeni User-agent satırı yeni grup başlatır. Aynı ürün belirteciyle eşleşen birden fazla özel grup varsa Google bu grupların kurallarını birleştirir; özel grup ile genel yıldız grubu birleştirilmez. Arama motoru botu en özgül ürün belirtecine ait grubu kullanır.
User-agent yönergesinin adı ve ürün belirteci büyük-küçük harfe duyarlı olmadan değerlendirilir. Buna karşılık Allow ve Disallow yol değerleri büyük-küçük harfe duyarlıdır. /Dosyalar/ ile /dosyalar/ aynı kural değildir. Bir gruptan önce yazılan yol kuralları geçerli bir hedef gruba bağlı olmadığından yok sayılabilir.
Boş Disallow: değeri engel oluşturmaz ve başka kurallarla konmuş engelleri kaldırmaz. İlgili grupta başka bir kısıtlayıcı kural yoksa tüm yolların taranmasına izin verilir. Disallow: / ise ilgili grup için kökten başlayan tüm yolları taramaya kapatır. Canlıya çıkışta unutulan bu tek satır geniş çaplı tarama kaybı oluşturabilir.
Allow ve Disallow Eşleşme Önceliğini Hesaplama
Yol kuralları alan adından sonraki bölüm için yazılır ve / ile başlar. Karşılaştırma URL yolunun başlangıcından yapılır; sorgu dizesi de eşleşmeyi etkileyebilir. Eşleşen kurallar arasında bayt cinsinden en uzun olan, yani yolu en ayrıntılı biçimde belirten kural kullanılır. Eşdeğer uzunluktaki Allow ve Disallow kuralları çatışırsa RFC 9309 ve Google davranışı daha izin verici olan Allow kuralını seçer.
| Kurallar | Test URL'si | Sonuç |
|---|---|---|
Disallow: /Allow: /urun/ | /urun/42 | Daha uzun Allow eşleşir; taramaya izin verilir. |
Disallow: /dosya | /dosyalar/rapor | Başlangıç eşleştiği için engellenir; dizin sınırı kendiliğinden oluşmaz. |
Disallow: /*.pdf$ | /belge.pdf | Yıldız değişken kısmı, dolar işareti URL sonunu eşleştirir; engellenir. |
Disallow: /*.pdf$ | /belge.pdf?surum=2 | Sorgu dizesi nedeniyle URL .pdf ile bitmez; bu kural eşleşmez. |
Yıldız işareti sıfır veya daha fazla karakteri, dolar işareti URL sonunu temsil eder. URL'deki gerçek *, $ veya # karakteri özel anlamıyla değil metin olarak eşleştirilecekse yüzde kodlama kullanılmalıdır. Örneğin dosya yolunun parçası olan # karakteri, URL içinde ve robots.txt kuralında %23 biçiminde yazılır. ASCII karakter kümesi dışında kalan karakterler ile URL'de özel anlam taşıyan ayrılmış karakterler, RFC 9309'un yüzde kodlama kurallarına göre karşılaştırılır.
Sitemap Bildirimini Doğru Yerleştirme
Sitemap (site haritası), tercih edilen URL'leri arama motorlarına keşif kaynağı olarak sunar. robots.txt içinde yönerge adı Sitemap olmalı ve değer protokol ile ana makineyi içeren tam URL biçiminde yazılmalıdır. Sitemap: /sitemap.xml göreli olduğu için yeterli değildir; Sitemap: https://example.com/sitemap.xml doğru biçimdir.
Bir dosyada birden fazla Sitemap satırı bulunabilir ve bu alan belirli bir User-agent grubuna bağlı değildir. Site haritası başka bir ana makinede barındırılabilir. Başka bir alan adında barındırılan site haritası robots.txt üzerinden bildiriliyorsa her harita yalnız ait olduğu sitenin URL'lerini içermeli ve ilgili sitenin robots.txt dosyası bu tam adresi göstermelidir. Google Search Console üzerinden gönderimde ise kapsanan bütün sitelerin sahipliği doğrulanırsa farklı sitelerin URL'leri tek haritada birleştirilebilir.
Site haritası göndermek tarama veya indeksleme garantisi vermez. Disallow ile engellenmiş bir URL'nin site haritasında bulunması çelişkili sinyaldir; arama motoru botu robots.txt kuralına göre içeriği taramayabilir.
HTTP Durum Kodları, Erişilemezlik ve Önbellek
robots.txt isteğinin Hiper Metin Aktarım Protokolü durum kodu, kurallar kadar önemlidir. RFC 9309 genel davranışı tanımlar; aşağıdaki ayrıntılar Google'ın güncel uygulamasını özetler.
| Yanıt | Google'ın Davranışı | Yapılandırma Notu |
|---|---|---|
2xx | Dosya alınır ve geçerli satırlar işlenir. | Canlı dosyada genellikle 200 OK beklenir. |
3xx | En az beş yönlendirme adımı izlenir; sınır aşılırsa dosya 404 gibi değerlendirilir. | Gereksiz zinciri kaldırın ve kök URL'yi doğrudan çalıştırın. |
4xx, 429 hariç | Geçerli robots.txt yokmuş gibi tarama kısıtı olmadığı varsayılır. | 401 veya 403 ile tarama hızını sınırlamayın. |
5xx veya ağ hatası | İlk 12 saatte tarama durur; sonra son geçerli kopya 30 güne kadar kullanılabilir. Önbellek yoksa kısıt olmadığı varsayılabilir. | DNS kaynaklı ad çözümleme hataları, zaman aşımı ve bağlantı kesilmesi de bu sınıfta ele alınır. |
Google 429 Too Many Requests yanıtını diğer 4xx kodlarının “kısıt yok” davranışına dahil etmez; tarama hızını yönetmek için güncel Google belgelerindeki yöntemleri kullanın. Uzun süren sunucu hatalarında 30 günden sonraki davranış sitenin genel erişilebilirliğine göre değişebilir.
Google robots.txt içeriğini genellikle 24 saate kadar önbellekte tutar. Sunucuya ulaşılamadığında süre uzayabilir; Cache-Control başlığındaki max-age değeri süreyi artırıp azaltabilir. Bu nedenle panelde ya da kaynak dosyada değişiklik görülmesi, bütün arama motoru botlarının aynı anda yeni kuralları kullanmaya başladığını kanıtlamaz.
Kuralları Hazırlama, Yayımlama ve Canlıda Test Etme
- URL envanteri çıkarın: Taranması gereken sayfaları, siteyi oluşturmak için gereken stil-komut dosyası kaynaklarını ve gereksiz URL kümelerini ayırın.
- Amacı belirleyin: Tarama yükünü mü yönetiyorsunuz, indekslemeyi mi engelliyorsunuz, yoksa özel içeriği mi koruyorsunuz? İkinci ve üçüncü hedef için robots.txt tek başına yeterli değildir.
- En küçük kuralı yazın: Geniş
Disallowyerine yalnız gerçek gereksiz yolu hedefleyin; gerekli istisnayı daha özgülAllowile açın. - Arama motoru botu gruplarını doğrulayın: Ürün belirtecini tahmin etmeyin; her arama motorunun resmi kullanıcı aracısı listesini kontrol edin.
- Site haritasını ekleyin: Erişilebilir tam URL'yi kullanın ve site haritasındaki URL kapsamını doğrulayın.
- Canlı yanıtı ölçün:
/robots.txtadresinin durum kodunu, içerik türünü, son içeriğini ve yönlendirme zincirini kontrol edin. - Örnek URL'leri test edin: Açık sayfa, engelli dizin,
Allowistisnası, büyük-küçük harf ve sorgu parametresi örneklerini ayrı değerlendirin. - Arama motoru görünümünü doğrulayın: Search Console robots.txt raporundaki alınan kopyayı ve hata bilgisini, sunucunun gerçek çıktısıyla karşılaştırın.
CMS (Content Management System) robots.txt dosyasını dinamik üretiyorsa sunucuda ikinci dosya oluşturmadan önce hangi katmanın canlı yanıtı verdiğini belirleyin. Paneldeki ayar, eklenti ve fiziksel dosya aynı anda farklı kurallar üretirse yalnız ziyaretçiye sunulan son HTTP yanıtı geçerlidir. Hatalı kurallar, bu yanıtı üreten dosyada veya CMS ayarında düzeltilir.
Dosyayı Etkisiz veya Riskli Hale Getiren Hatalar
- Yanlış konum veya kapsam: Alt klasördeki, farklı alt alan adındaki ya da farklı porttaki dosyanın bütün siteyi yönettiğini varsaymak.
- Canlıda kalan tam engel: Test ortamı için yazılmış
Disallow: /kuralını üretimde yayımlamak. - Gerekli kaynakları engellemek: Sayfanın görünümünü veya işlevini oluşturan stil ve komut dosyalarını kapatarak arama motoru botunun sayfayı eksik değerlendirmesine yol açmak.
- Desteklenmeyen alanlara güvenmek: Googlebot için
Crawl-delayveya robots.txt içindekinoindexsatırının çalışacağını varsaymak. - Yolu sır sanmak: Hassas yönetim ya da yedek yollarını herkese açık dosyada listeleyip gerçek erişim denetimi uygulamamak.
- Yalnız satır sırasına bakmak: En uzun yol eşleşmesini, eşitlikte
Allowönceliğini ve sorgu dizesini hesaba katmamak. - Canlı yanıtı okumamak: Dosya yerine HTML hata sayfası, oturum açma ekranı veya eski önbellekli kopya sunulduğunu fark etmemek.
Tarama, İndeksleme ve Erişim Güvenliğini Ayırma
Bir URL Disallow ile taramaya kapatılsa bile başka sayfalardan bağlantı alıyorsa Google adresi içeriksiz bir sonuç olarak gösterebilir. İndekslemeyi engellemek için HTML sayfasında robots meta etiketiyle noindex kullanın ve arama motoru botunun etiketi okuyabilmesi için taramaya izin verin.
PDF, görsel veya başka HTML dışı kaynaklarda X-Robots-Tag HTTP yanıt başlığı kullanılabilir. Özel veya hassas içerikte ise parola, oturum ve sunucu tarafı yetkilendirme uygulayın. robots.txt, kurala uymayan istemciden koruma sağlamaz.
URL Yapısı Değiştiğinde Dosyayı Yeniden Denetleme
Yeni dizin, alan adı taşıması, HTTP-HTTPS geçişi, alt alan adı veya port değişikliği robots.txt kapsamını değiştirebilir. Eski yolları temizleyin, yeni site haritasını bildirin ve gerekli kaynakların açık kaldığını doğrulayın. Dosyayı mümkün olduğunca kısa tutmak hangi kuralın hangi URL'yi etkilediğini izlemeyi kolaylaştırır.
Değişiklikten sonra yalnız dosyanın metnine bakmayın. HTTP durumunu, önbellek başlıklarını, arama motorunun aldığı son kopyayı ve temsili URL eşleşmelerini yeniden kontrol edin.